مقدمة
لو بتشتغل بالذكاء الاصطناعي وعندك بيانات خاصة بشركتك أو مشروعك، أكيد واجهتك مشكلة إن الـ LLM مش عارف حاجة عنها. هنا بالظبط بييجي دور RAG باستخدام N8N، وهو حل عملي وسهل التنفيذ حتى لو مش مبرمج محترف. في المقال ده هنعدي خطوة بخطوة إزاي تبني نظام RAG كامل من غير تعقيد.
إيه هو نظام RAG وليه محتاجه مع N8N
يعني إيه RAG؟ هو اختصار لـ Retrieval-Augmented Generation، وهو أسلوب بيخلي الـ LLM يرجع لمصدر بيانات خارجي (زي مستنداتك أو ملفاتك) قبل ما يرد عليك، بدل ما يعتمد بس على اللي اتدرب عليه. ده بيحل مشكلة إن النموذج “يهلوس” أو يديك معلومة قديمة أو غلط.
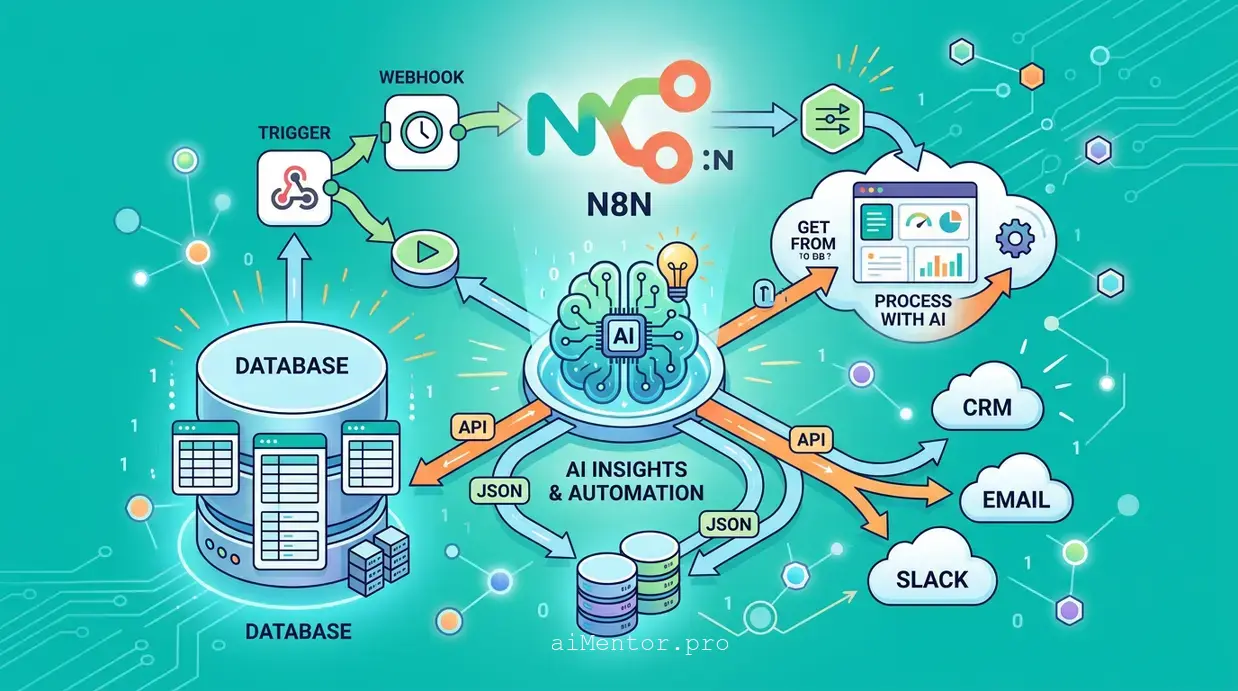
استخدام N8N هنا بيدّيك ميزة إنك تبني الـ workflow بصريًا من غير ما تكتب كود كتير، وتربط بين أدوات مختلفة زي قاعدة بيانات المتجهات والـ LLM في مكان واحد. ده بيوفر وقت كبير مقارنة ببناء النظام من الصفر بكود.
إزاي تجهز قاعدة بيانات المتجهات قبل ما تبدأ
الخطوة الأولى الأساسية هي تجهيز Vector Database عشان تقدر تخزن فيها البيانات بشكل قابل للبحث الدلالي. من غيرها مينفعش نظام RAG يشتغل أصلاً.
تقدر تستخدم أدوات زي Pinecone أو Supabase أو حتى Qdrant، المهم إنك تحول مستنداتك لـ embeddings الأول عن طريق موديل زي text-embedding من OpenAI. لو عايز تتعمق في الخطوة دي بالتفصيل شوف شرح إعداد قاعدة بيانات المتجهات في N8N عشان تفهم الفرق بين الأدوات ده وتختار المناسب لمشروعك.
خطوات بناء RAG كامل في N8N من الصفر
بناء النظام بيتم من خلال سلسلة nodes مترابطة، كل واحدة ليها دور محدد في رحلة البيانات من الملف لحد الرد النهائي.
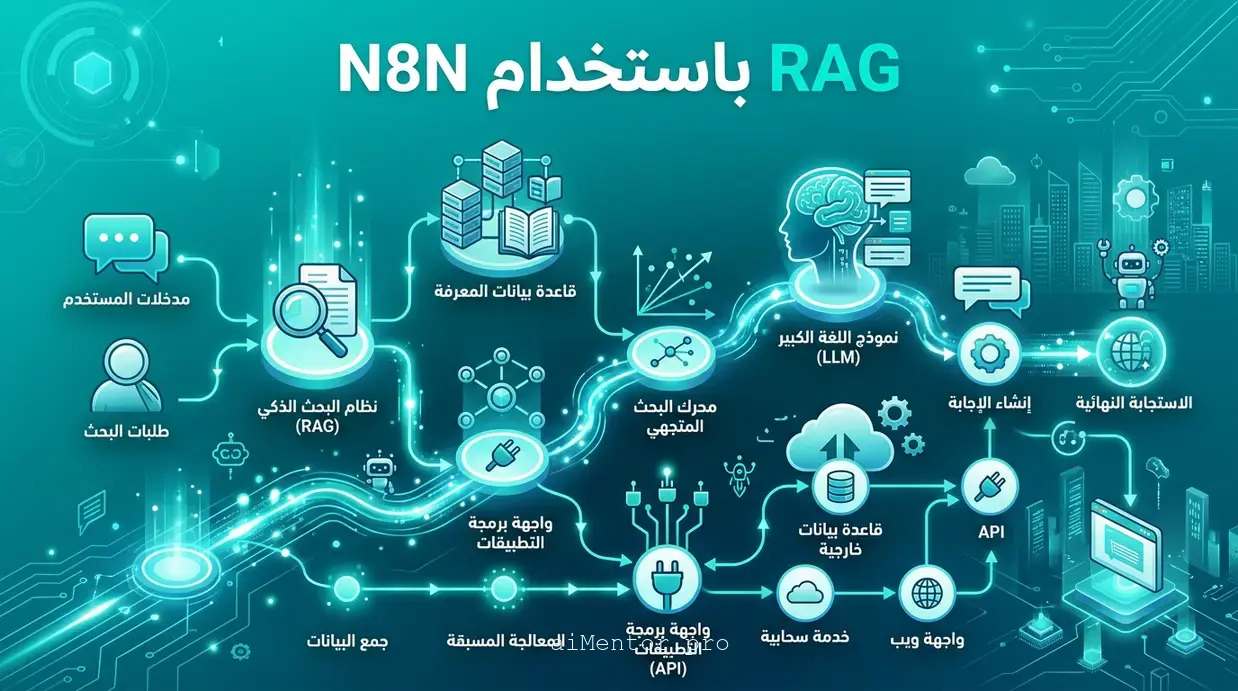
- node لاستقبال الملفات أو المستندات (PDF، Google Docs، أو حتى نص مباشر)
- node لتقسيم النص لقطع صغيرة (chunks) عشان الموديل يقدر يتعامل معاها
- node لتحويل القطع دي لـ embeddings وتخزينها في قاعدة بيانات المتجهات
- node للبحث عن أقرب نتائج لسؤال المستخدم
- node أخير بيبعت النتائج مع السؤال للـ LLM عشان يكوّن إجابة نهائية
الغلطة الشائعة اللي بيقع فيها المبتدئين إنهم بيبعتوا المستند كامل للموديل من غير تقسيم، وده بيسبب مشاكل في حدود الـ tokens وبياخد تكلفة أكبر. الطريقة الصح إنك دايمًا تقسم النص لقطع متوسطة الحجم (حوالي 300-500 كلمة) مع overlap بسيط بين القطع عشان السياق متتقطعش.
إزاي تربط LangChain مع الـ workflow بتاعك
N8N بيدعم تكامل مباشر مع LangChain وده بيسهّل عليك بناء منطق أعقد من غير ما تكتب كل حاجة يدوي. تقدر تستخدم nodes جاهزة زي Chain، Retriever، و Memory مباشرة جوه الـ workflow.
لو حابب تتعلم التفاصيل دي بشكل أعمق، في شرح كامل عن طريقة دمج LangChain جوه N8N بيوضح إزاي تستخدم الـ memory node عشان المحادثة تفضل متصلة ومترابطة مع المستخدم بدل ما كل سؤال يتعامل معاه لوحده.
أفضل طريقة تحول نظام RAG لإيجنت ذكي يتفاعل مع المستخدم
أفضل طريقة هي إنك تضيف طبقة Agent فوق نظام RAG بدل ما يفضل مجرد نظام بحث واسترجاع ثابت. الإيجنت بيقدر ياخد قرار إمتى يرجع لقاعدة البيانات وإمتى يستخدم أدوات تانية زي API خارجي أو حساب أرقام.
ده بيخلي التجربة أقرب لمساعد ذكي حقيقي، مش مجرد محرك بحث بيرد بجمل جاهزة. لو عايز دليل عملي لبناء الإيجنت ده، شوف طريقة بناء إيجنت ذكي باستخدام N8N وهتلاقي خطوات تفصيلية تكمل بيها اللي بنيته هنا.
لو عايز تاخد المهارة دي لمستوى احترافي وتتعلم بناء أنظمة أتمتة ذكية كاملة، ينفع تشوف كورسات الأتمتة بالذكاء الاصطناعي من AIMENTOR اللي هتساعدك تبني مشاريع حقيقية خطوة بخطوة.
الأسئلة الشائعة
ملخص المقالة
بناء RAG باستخدام N8N مش معقد زي ما يبدو، المهم إنك تبدأ بتجهيز قاعدة بيانات المتجهات صح، وتقسم بياناتك كويس، وتربط الـ workflow بـ LangChain عشان تاخد أقصى استفادة. وبعد كده تقدر تطور النظام لإيجنت ذكي يفهم السياق ويتفاعل مع المستخدم بشكل طبيعي.
اتعلم الأتمتة بالذكاء الاصطناعي باستخدام n8n
كورس عملي كامل من الصفر، تبني فيه أول نظام أتمتة بإيدك — مساعد إيميلات ذكي يقرأ الرسائل ويصنّفها ويرد عليها تلقائيًا. من غير أي خلفية برمجية.
- 26 درسًا عملي في 6 أقسام
- مشروع نهائي كامل تقدر تستخدمه في شغلك
- شرح بالعامية المصرية خطوة بخطوة